Modelo portátil e nativo do Git para memória de IA legível por agentes
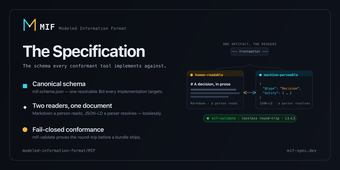
MIF (Formato de Informação Modelada), do Formato de Informação Modelada, fornece um modelo de dados neutro em relação a fornecedores para intercâmbio de conhecimento de IA portátil. Ele empacota Markdown editável por humanos e JSON-LD consumível por máquinas para criar pacotes de conhecimento legíveis por agentes e de primeira local para assistentes integrados ao MCP e fluxos de trabalho agentes. Os elementos-chave incluem uma fonte Markdown canônica, projeções JSON-LD derivadas, proveniência W3C PROV, validade bi-temporal e integração com o servidor MCP. Engenheiros de IA e gerentes de conhecimento o utilizam para manter a memória de IA nativa do Git e reduzir o inchaço de tokens.
Quais tarefas você pode realmente usar o MIF?
O MIF aborda o problema da memória persistente de IA, produzindo pacotes de contexto consumíveis por agentes que os agentes podem navegar com alta precisão. O formato define tipos semânticos, episódicos e procedimentais e suporta relacionamentos tipados para mapear entidades complexas. As equipes usam esses pacotes para expor contexto estruturado a assistentes durante a resolução de prompts, para manter uma fonte de verdade editável por humanos e para representar conhecimento de uma maneira que os agentes possam consultar programaticamente.
Quão precisas e rastreáveis são as projeções legíveis por máquina?
As projeções derivadas incluem metadados alinhados ao W3C PROV e rastreamento bi-temporal para documentar a origem e a atualidade, o que melhora a rastreabilidade para processamento posterior. A precisão das saídas voltadas para o agente depende da qualidade do Markdown canônico, uma vez que humanos são os autores da fonte de verdade. Praticamente, a confiabilidade aumenta quando os autores incluem campos de proveniência e janelas de validade explícitas durante a autoria, porque o formato depende desses sinais para evitar que contextos obsoletos sejam servidos.
Quais entradas e padrões de implantação são necessários?
O fluxo de trabalho é nativo de sistema de arquivos e Git, portanto, os projetos armazenam pacotes de conhecimento como arquivos de texto simples em vez de em bancos de dados vetoriais externos. O MIF pode ser executado como um servidor MCP (mif-mcp) e se integra com clientes que suportam o Protocolo de Contexto de Modelo; a implantação se adapta a ambientes Node.js e TypeScript e integrações comuns de editores, como o VS Code. O design remove uma camada de banco de dados obrigatória e permite que as equipes mantenham a memória dentro de um repositório de projeto.
O MIF é prático em comparação com sistemas de memória suportados por banco de dados?
O MIF enfatiza a portabilidade neutra em relação a fornecedores em vez de recursos de banco de dados, usando Markdown simples como o artefato canônico, o que evita o bloqueio em formatos de armazenamento proprietários. Sua conformidade com o OKF auxilia a interoperabilidade com outras ferramentas que falam o mesmo modelo de transporte. Projetos que precisam de experimentação rápida com memória local-primeiro e proveniência explícita podem adotá-lo sem introduzir um armazenamento vetorial externo, embora a adaptação de pipelines existentes possa exigir o mapeamento de esquemas atuais para o modelo de conteúdo opinativo do MIF.
MIF atende equipes de engenharia que priorizam contexto de IA portátil e revisável
MIF é uma opção prática para engenheiros de IA e gerentes de conhecimento que precisam de memória portátil, local-primeiro que os agentes possam ler. Sua principal limitação é a dependência de arquivos de origem curados para a correção da saída, portanto, as equipes devem adicionar etapas de revisão e validação do autor em seu pipeline de conteúdo. Tratado como parte de um fluxo de trabalho de verificação mais amplo, ele se encaixa em projetos que preferem memória nativa de repositório em vez de serviços de banco de dados externos.